

شاب مغربي يبني نموذجا لـAi بالأمازيغية من الصفر.. ويدربه على تيفيناغ بحاسوب محمول
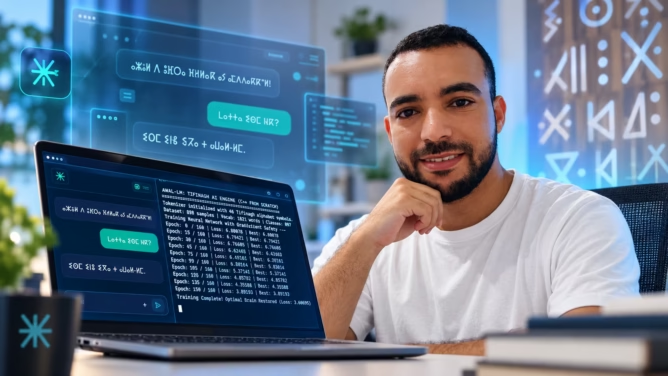
طور المبرمج المغربي رشيد نيشان نموذجا للذكاء الاصطناعي يحمل اسم Awal LM، مخصصا لمعالجة اللغة الأمازيغية وحروف تيفيناغ، في مشروع شخصي يقول إنه بناه من الصفر بالاعتماد على لغة البرمجة ++C والرياضيات، دون الاستناد إلى أطر التعلم الآلي الجاهزة من قبيل PyTorch وTensorFlow.
نيشان، المقيم بمدينة الدار البيضاء والمنحدر من منطقة تافراوت بسوس، قال إن علاقته بالمشروع انطلقت من إحساسه بضعف حضور اللغة الأمازيغية داخل التقنيات الحديثة، رغم أنه لم تتح له خلال نشأته فرصة تعلمها وتداولها بشكل واسع في محيطه اليومي أو في مساره الدراسي.
وأوضح المطور المغربي في حوار مع جريدة “العمق”، أن هذا المعطى دفعه إلى محاولة توظيف خبرته في البرمجة والرياضيات لخدمة اللغة الأمازيغية، مضيفا: “إذا لم أكن قد أتقنت التحدث بها صغيرا، فسأجعل الحاسوب والذكاء الاصطناعي ينطق بها ويكتبها بحروفها الأصيلة اليوم”.
وبحسب نيشان، ولدت فكرة Awal LM مع الانتشار الكبير لنماذج الذكاء الاصطناعي التوليدي، بعدما لاحظ محدودية حضور اللغات الإفريقية والأمازيغية داخل المنتجات التي تطورها كبريات شركات التكنولوجيا العالمية، بسبب قلة البيانات الرقمية المتاحة لهذه اللغات وضعف مردودها التجاري مقارنة باللغات واسعة الانتشار.
وفي ما يلي نص الحوار الكامل:
- من هو رشيد نيشان؟ وكيف التقت لديك خبرة البرمجة بقضية اللغة الأمازيغية؟
أنا شاب ومطور برمجيات مغربي، مقيم بمدينة الدار البيضاء، وتنحدر أصولي من منطقة تافراوت العريقة بسوس. بحكم نشأتي في الدار البيضاء، لم تتح لي فرصة تعلم اللغة الأمازيغية وتداولها في محيطي اليومي أو خلال مساري الدراسي، لكن هذا المعطى لم يقطع صلتي بجذوري، بل ولّد لدي “غيرة إيجابية” وشعورا عميقا بالمسؤولية تجاه لغتي الأم وهويتي الوطنية.
ولأن مجالي وشغفي هما البرمجة والرياضيات، قررت أن أترجم هذا الانتماء بشكل عملي؛ فإذا لم أكن قد أتقنت التحدث بها صغيرا، فسأجعل الحاسوب والذكاء الاصطناعي ينطقان بها ويكتبانها بحروفها الأصيلة اليوم.
- متى وكيف ولدت فكرة Awal LM؟ وهل كانت هناك لحظة معينة قررت فيها أن تبني نموذجا أمازيغيا من الصفر؟
ولدت فكرة Awal LM من رحم الإحباط الإيجابي؛ فمع الطفرة العالمية التي أحدثتها نماذج مثل ChatGPT، لاحظت أن كبرى الشركات التكنولوجية تتعامل مع اللغات الإفريقية والأمازيغية بوصفها لغات “هامشية” أو ثانوية، بسبب قلة البيانات وضعف العائد التجاري بالنسبة إليها.
اللحظة الحاسمة كانت حين أدركت أنه لا يمكننا أن نظل في مقعد المتفرج، أو ننتظر من وادي السيليكون أن يرقمن تراثنا؛ فقررت خوض التحدي وبناء محرك ذكاء اصطناعي محلي ومستقل، ينطلق من خصوصية اللغة الأمازيغية وبإمكانياتنا الذاتية.
- لماذا اخترت بناء النموذج من الصفر بلغة ++C بدل الاعتماد على أطر جاهزة مثل PyTorch أو TensorFlow؟ وما الذي يكسبه المشروع من هذا الاختيار؟
كان الاختيار تقنيا واقتصاديا بامتياز. تدريب النماذج عبر الأطر الجاهزة مثل PyTorch يفرض متطلبات عتادية ضخمة وتكاليف مرتفعة في استئجار بطاقات الرسوميات (GPUs) والخوادم السحابية، وهي إمكانيات غير متاحة لمشروع فردي مستقل.
الاعتماد على لغة منخفضة المستوى مثل ++C، إلى جانب الرياضيات الصرفة (Linear Algebra & Calculus)، أتاح لي التحكم الكامل في إدارة الذاكرة واستهلاك موارد المعالج وذاكرته المخبئية (CPU Cache)، مما مكنني من تدريب النموذج وتشغيله على حاسوب محمول عادي (Laptop) ورفعه على خادم بسيط.
ما يكسبه المشروع من هذا الاختيار هو الخفة، والاستقلالية التامة عن المكتبات البرمجية الخارجية، وسرعة استجابة كبيرة لا تتجاوز بضع ميلي ثوان.
- بنيتم معالجا لغويا (Tokenizer) خاصا بحروف تيفيناغ الـ33 المعتمدة من المعهد الملكي للثقافة الأمازيغية. ما أصعب ما واجهكم في جعل الآلة «تقرأ» تيفيناغ وتفهمها؟
كان التحدي الأكبر تقنيا بحتا؛ فحروف تيفيناغ تقع ضمن ترميز UTF-8 متعدد البايتات (Multi-byte)، حيث يُمثَّل كل حرف بثلاثة بايتات، مقارنة بالحروف اللاتينية الأساسية التي تُمثَّل ببايت واحد.
بعض الأدوات البرمجية الكلاسيكية قد تتعامل بشكل غير سليم مع هذه الحروف أو تفككها على مستوى البايتات. لذلك قمت ببرمجة Tokenizer من الصفر، يتعامل مع البايتات بدقة ويحافظ على سلامة حروف تيفيناغ الـ33، مع تدريب النموذج تدريجيا، بدءا من فهم الأبجدية، مرورا بتركيب الكلمات، وصولا إلى استيعاب السياق الدلالي داخل طبقات الشبكة العصبية.
- تحدثتم عن دقة مطابقة تصل إلى 98 في المائة وسرعة استجابة أقل من 5 ميلي ثانية. ماذا تعني هذه الأرقام عمليا لمستخدم عادي يجرب النموذج لأول مرة؟
عمليا، تعني أن المستخدم حين يفتح موقع awallm.com ويكتب تحية أو سؤالا بتيفيناغ، لا يشعر بأي تأخير أو بطء؛ فالجواب يظهر بشكل شبه فوري، بفضل خفة كود ++C وغياب طبقات برمجية ثقيلة.
أما نسبة المطابقة (Match)، فتعني أن النموذج يفهم المقصد والنية (Intent) من السؤال بدقة عالية، ويستحضر الإجابة الأنسب لغويا وسياقيا.
- أكبر تحديات اللغات «قليلة الموارد» هو ندرة البيانات. من أين جمعتم النصوص الأمازيغية التي تدرب عليها النموذج؟ وكيف تعاملتم مع تعدد اللهجات الأمازيغية داخل المغرب وخارجه؟
ندرة البيانات كانت ولا تزال العقبة الكبرى. قمت بجمع نصوص ومحادثات أولية من مقالات ويكيبيديا الأمازيغية ومصادر رقمية مفتوحة، مع استشارة أساتذة ومختصين لتدقيق النصوص نحويا وإملائيا قبل تحويلها إلى صيغة التدريب المعيارية (JSONL).
اعتمدنا في الأساس على الأمازيغية المعيارية المعتمدة مؤسساتيا من طرف المعهد الملكي للثقافة الأمازيغية (IRCAM)، باعتبارها أرضية جامعة وموحدة، مع إبقاء بنية النموذج مرنة وقابلة لاستيعاب الخصوصيات اللسانية الغنية، مثل تشلحيت وتاريفيت وتامازيغت، عبر نظام التعلم المجتمعي الذي أطلقناه في المنصة.
- هل يتعامل النموذج مع الأمازيغية بحروف تيفيناغ فقط، أم أيضا بالحرفين العربي واللاتيني اللذين يكتب بهما كثير من الناطقين بها؟
ينصب التركيز الجوهري والأولوية في النسخة الحالية على حروف تيفيناغ؛ إيمانا منا بضرورة توطين الحرف الرسمي للأمازيغية في الفضاء الرقمي وعدم تركه حبيس اللافتات.
ومع ذلك، فالنموذج مبرمج للتعرف على المدخلات الشائعة بالحرفين العربي واللاتيني، ويوجه المستخدم بلباقة إلى التفاعل بحروف تيفيناغ عبر لوحة المفاتيح المدمجة في الموقع. ونعمل مستقبلا على تطوير قدرات الترجمة الآلية والتحويل المتبادل بين أنظمة الكتابة الثلاثة.
- لماذا تصرون على أن يكون المشروع مفتوح المصدر ومجانيا؟ ومن يمكنه الاستفادة منه اليوم؟
لأن قضية اللغة والهوية لا تقبل الاحتكار؛ فالتراث اللغوي ملك لجميع المغاربة وللإنسانية جمعاء. فتح المصدر عبر Hugging Face يعزز الثقة، ويسمح للطلبة والباحثين والمطورين المغاربة بالاطلاع على الكود والبناء عليه وتطوير تطبيقات محلية.
كما يمكن للشركات والمؤسسات الثقافية ومنشئي المحتوى الاستفادة اليوم من واجهة المطورين (API) لدمج الذكاء الاصطناعي الأمازيغي في منظوماتهم بكل بساطة.
- كيف ترون موقع الأمازيغية في سباق الذكاء الاصطناعي العالمي؟ وهل تخشون أن تتسع الفجوة الرقمية بين اللغات الكبرى ولغات مثل الأمازيغية؟
الفجوة الرقمية واقعية ومخيفة إذا لم نتحرك. الشركات العالمية الكبرى تتحرك بمنطق الربح وحجم قاعدة المتحدثين، واللغات التي لا تمتلك تمثيلا رقميا قويا اليوم مهددة بـ”الانقراض الرقمي” خلال العقود المقبلة.
Awal LM بمثابة جرس إنذار ومبادرة مقاومة تكنولوجية تثبت أننا قادرون، بسواعد وطنية، على حجز مقعد للأمازيغية في هذا القطار السريع دون انتظار الدعم الخارجي.
- هل تواصلتم مع مؤسسات معنية باللغة الأمازيغية أو جامعات أو فاعلين تقنيين؟ وكيف يمكن لهؤلاء دعم المشروع أو البناء عليه؟
حتى هذه اللحظة، المشروع مبادرة شخصية ومستقلة، ولم أتواصل بعد مع أي جهة رسمية أو مؤسسة. لكننا منفتحون ومتحمسون جدا للتعاون مع مؤسساتنا الوطنية، وعلى رأسها المعهد الملكي للثقافة الأمازيغية (IRCAM)، والجامعات المغربية، ووزارة الانتقال الرقمي.
الدعم الذي نحتاجه اليوم يتمثل أساسا في دعم لغوي، من خلال تزويدنا بقواعد بيانات ونصوص دقيقة ومعتمدة، ودعم تقني لتوفير قدرات حوسبة متقدمة تتيح لنا تدريب نماذج أكبر، تضم مليارات المعلمات.
- ما أصعب العقبات التي واجهتكم: تقنية، مادية، أم بشرية؟ وكيف تمولون المشروع وتستمرون فيه؟
تجاوزنا العقبات التقنية بالصبر والشغف بالبرمجة والرياضيات. أما العقبة الحقيقية فتبقى مادية بالدرجة الأولى؛ فبناء نماذج الذكاء الاصطناعي يتطلب موارد مالية ومعدات حوسبة مكلفة.
المشروع ممول حاليا بجهد ومال شخصيين، والدافع والوقود الحقيقيان للاستمرار هما الدعم المعنوي والتشجيع الكبير اللذان لمستهما من متابعي صفحتي وأبناء وطني الذين احتفوا بهذا الإنجاز.
- ما خطوتكم المقبلة بعد النسخة الثانية؟ هل تفكرون في الصوت، أو تطبيق هاتفي، أو توسيع قاعدة النصوص؟
طموحنا لا يتوقف عند الدردشة النصية. خارطة الطريق للمرحلة المقبلة تشمل ثلاثة محاور:
أولا، توسيع قاعدة البيانات اللغوية لتشمل مجالات متخصصة كالقانون والتاريخ والعلوم.
ثانيا، العمل على معالجة الصوت (Speech-to-Text & Text-to-Speech)، لتمكين النموذج من الاستماع إلى الأمازيغية والنطق بها.
ثالثا، إطلاق تطبيق هاتفي مخصص، وتوسيع نطاق واجهة المطورين (API) لتسهيل استخدام النموذج في مختلف الأنظمة والتطبيقات.
- ما رسالتك الأخيرة للشباب المغربي الذي يظن أن بناء نماذج ذكاء اصطناعي «بلغتنا» أمر مستحيل؟
رسالتي لكل شاب ومطور مغربي: “المستحيل مجرد فكرة في أذهاننا”. لا تجعلوا قلة الإمكانيات أو غياب بطاقات الرسوميات المتطورة عائقا أمامكم.
بامتلاك الأساسيات الصحيحة، والشغف الحقيقي بالرياضيات، والتحكم في لغات برمجة منخفضة المستوى مثل ++C، يمكن لحاسوب محمول متواضع في أي بيت مغربي أن يكون منطلقا لبناء ما يعتقد البعض أن تحقيقه حكر على كبريات الشركات العالمية.
لغاتنا وتراثنا أمانة في أعناقنا، ومستقبل التكنولوجيا يبنيه من يبتكر، لا من يستهلك فقط.
اترك تعليقاً